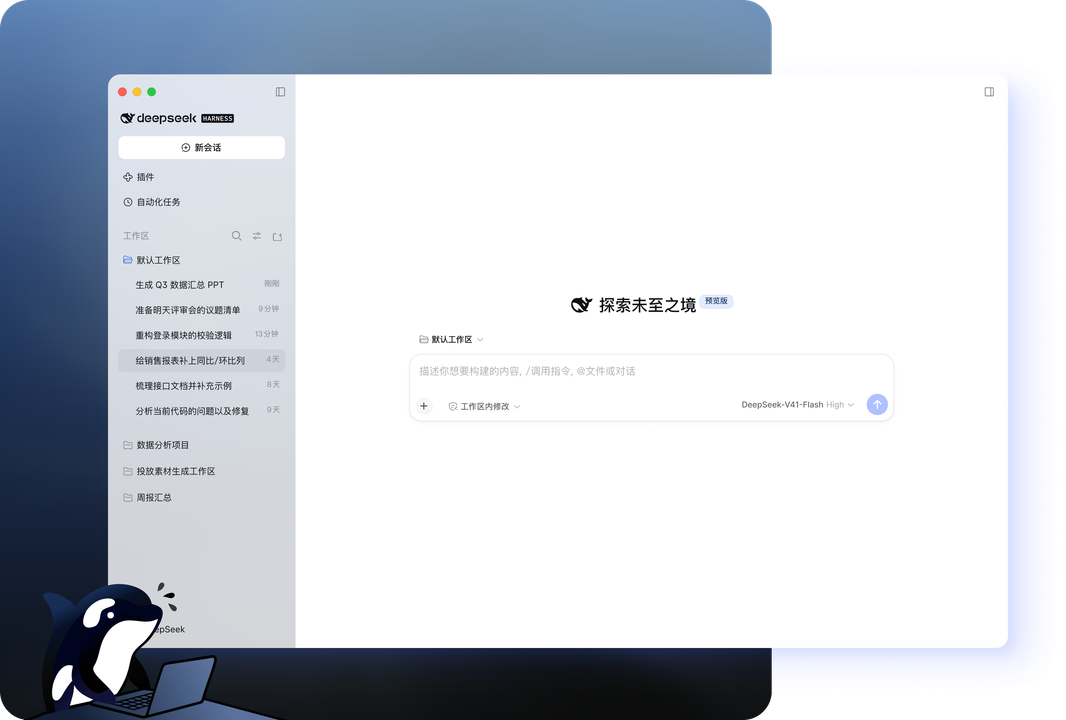
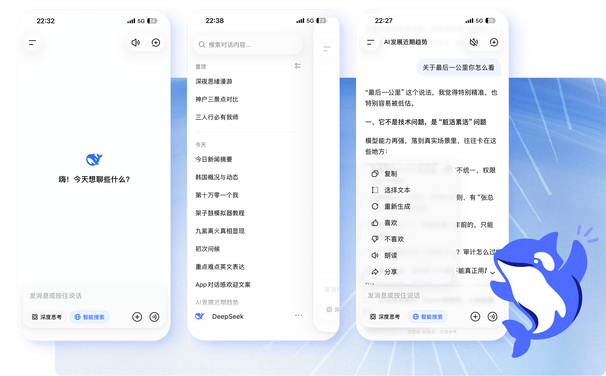
网页版免安装,帮助页有调用示例

DeepSeek

这里是长链思考 - 探索未竟之问。题目、报错或整篇材料都可以贴进来,没说清的条件可以在下一轮补上。

685B 总参数 MoE 架构
128K 长上下文完整支持
92.6% MATH-500 严谨准确率
DeepSeek-R1 深度思考中
请用 Python 实现一个高精度自注意力算子,并给出理论时间复杂度。
思考过程 · 16 秒
已完成算子实现。对于序列长度为 N、嵌入维度为 D 的输入,计算复杂度为 O(N² · D)。
import torch import torch.nn as nn class ScaledDotProductAttention(nn.Module): def __init__(self, d_k): super().__init__() self.scale = 1.0 / (d_k ** 0.5) def forward(self, q, k, v): scores = torch.matmul(q, k.transpose(-2, -1)) * self.scale attn = torch.softmax(scores, dim=-1) return torch.matmul(attn, v)
为什么选择 DeepSeek 深度求索

推理怎么展示、长文上限、接口怎么接,分三块写。

原生深度推理

原生深度推理引擎

R1 先写依据,再给结论。数学证明和代码排错可以顺着步骤检查。

打开网页版 →
超大规模 MoE

超大规模 MoE 稀疏激活

总参数 685B,计算时只激活一部分。上下文最长 128K。

看技术说明 →
极低成本与开源生态

按量计费,也能本机运行

调用写法和常见接口一致。也可以用 Ollama 在自己的机器上跑。

看价格 →

多头潜在注意力 (MLA) 压缩框架

MLA 把键值缓存压到更低的维度,128K 对话占用的显存更小。

缓存更小 上下文 128K 适合长对话
探索 MLA 原理
MLA 注意力架构
DualPipe 双向流水线并行

DualPipe 并行调度

训练时把计算和机器之间的通信叠在一起,减少互相等待。

计算与通信重叠 支持多机并行 自有通信实现
技术细节详解

可以直接这样用

数学、代码、长文和写稿,都在网页里完成。

复杂数学推导

高难度数学推演

严密拆解代数、微积分与前沿竞赛题型,给出完整步骤。

立即求解
全栈代码工程

全栈代码重构

精准排查疑难 Bug,生成高质量模块化工程代码与测试用例。

编写代码
学术论文深度研读

长文解析与研读

128K 超长文献一次性通读,提炼关键证据链与实验创新点。

研读论文
专业创意与文案

专业文案与策划

结构严谨的商业企划、公文汇报与深度思想长文一键构思。

开启写作

接到自己的程序里

帮助页有最小可运行示例和价格表。

标准 API

标准 API 接口调用

把地址和密钥换成这里的即可,请求体不用重写。

获取 API Key
本地私有化部署

本地私有化集群部署

可以用 Ollama 或 vLLM 在自己的机器上运行,数据留在本机。

阅读部署文档
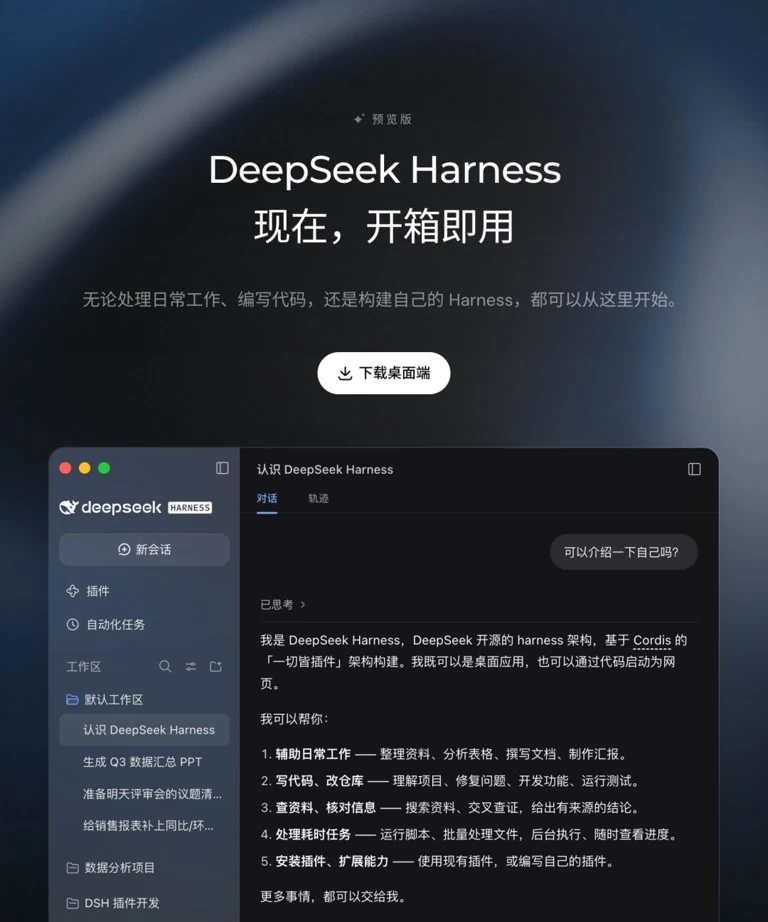
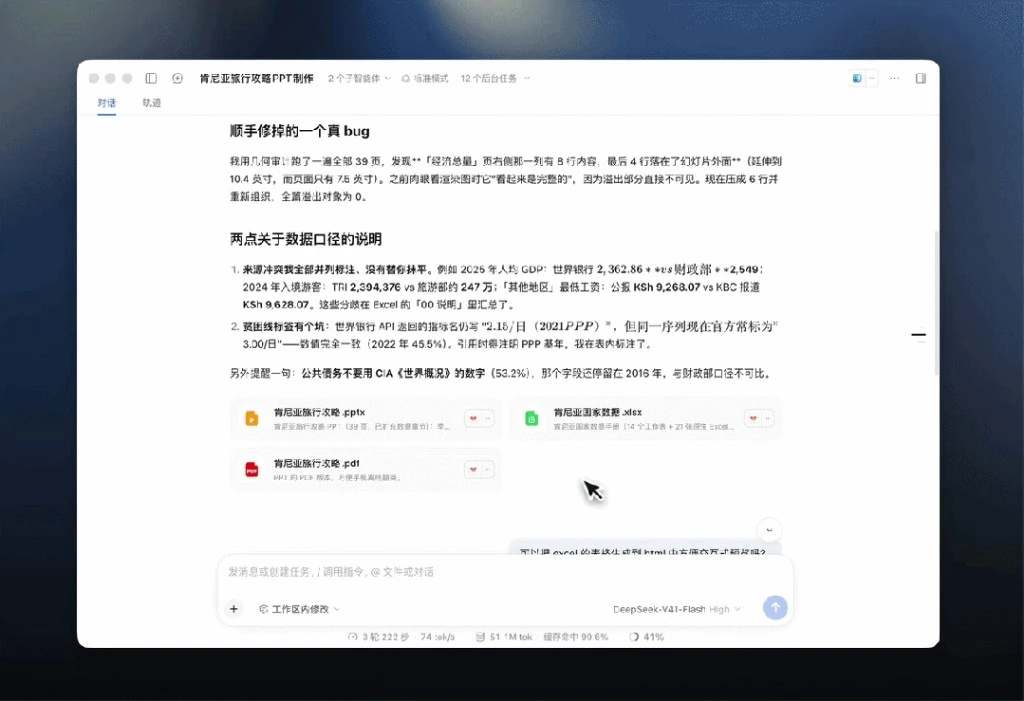
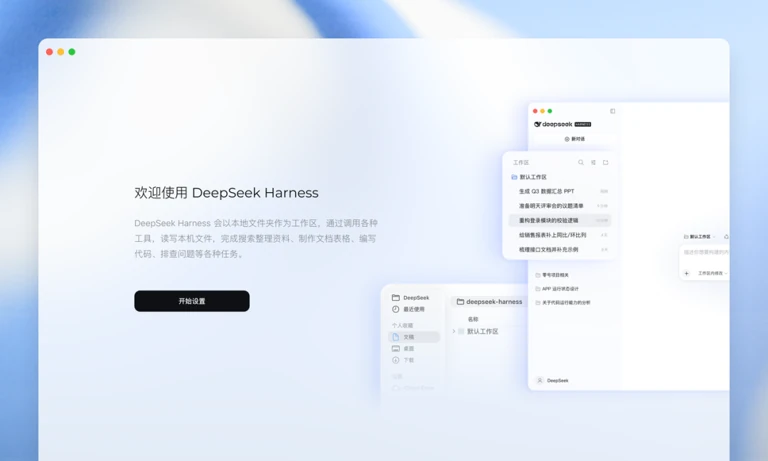
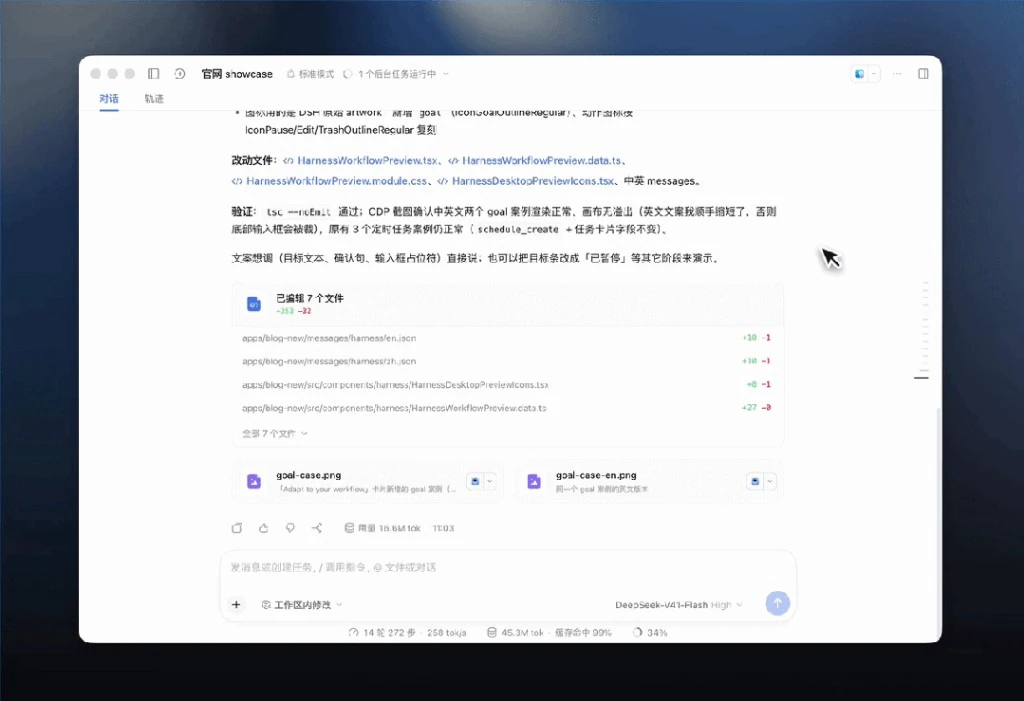
任务编排 Harness

DeepSeek Harness 智能编排

把提问、检索和工具调用按步骤串起来,方便重复执行。

查看 Harness

使用时的具体情况

下面是三件具体的使用情况。

“同一道题换个问法,前后结论对得上。”

张

林

学生

“旧的调用代码只改了地址和密钥,请求体不用重写。”

陈

吴

应用开发

“写大纲时它标出哪一段还缺依据,而不是直接生成一整篇。”

李

郑

编辑

DeepSeek DeepSeek官网 DeepSeek网页版 Deep Seek DeepSeek网页版入口 DeepSeek AI DeepSeek api开放平台 DeepSeek Harness DeepSeek - 探索未至之境 DeepSeek R1深度思考模型 DeepSeek V3满血版在线使用 DeepSeek网页版在线对话 DeepSeek代码生成与数学推理 DeepSeek长文本128K上下文

先在网页里试一轮

左边进对话,右边看接口。两边是同一套模型。

免费进入网页版对话 阅读开发接口文档